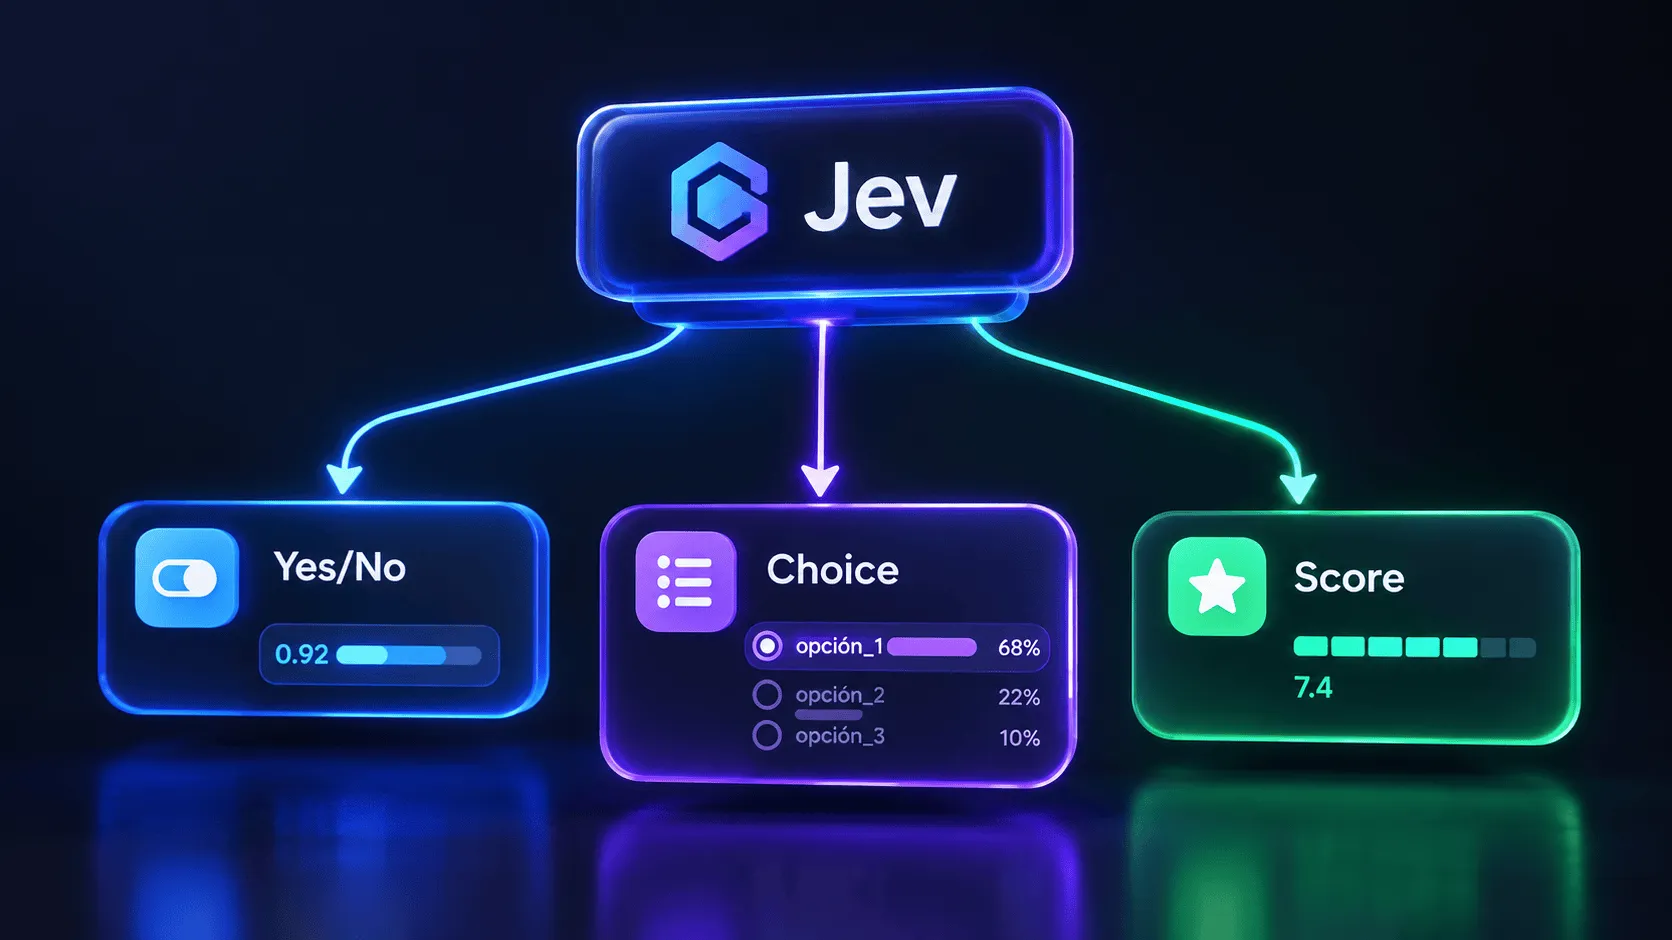

En casi cualquier proyecto que usa inteligencia artificial aparece el mismo desperdicio: un modelo potente lee un mensaje y responde con un párrafo cuando tú solo necesitabas un valor. Le pides que clasifique un ticket y te devuelve prosa; le pides que califique urgencia y te devuelve una explicación. Funciona, pero estás usando un motor de razonamiento para una pregunta que, en el fondo, es una condicional: ¿es esto una queja?, ¿a qué equipo va?, ¿qué tan grave es?
Jev, el primer modelo de TypeSafe AI, ataca exactamente ese punto. No genera texto: recibe un estado y un conjunto de preguntas, y devuelve decisiones tipadas con probabilidades que tu código puede usar directo, sin parsear nada. La empresa lo presenta como un modelo System One, el nombre que Daniel Kahneman popularizó en Thinking, Fast and Slow: juicios rápidos e intuitivos, en lugar del razonamiento lento y deliberado de un LLM.
Este artículo explica qué es, qué puedes pedirle, cuánto cuesta, qué no hace bien y cómo probarlo hoy. Todo lo que vas a leer sobre capacidades y precios sale de la documentación oficial de TypeSafe; donde hay opinión, la marco como opinión.
Un modelo que devuelve decisiones, no texto
Un LLM está diseñado para producir texto que una persona va a leer. Cuando necesitas que el modelo emita un juicio que tu código va a consumir, se produce un desajuste: estás forzando a un sistema de generación de texto a soltar una estructura, y luego parseando el resultado para volver a convertirlo en algo de lo que tu aplicación pueda depender.
Jev invierte la lógica. Evalúa preguntas tipadas contra un estado y devuelve resultados estructurados directamente. No hay generación de texto, no hay parseo, no hay que recuperar un valor de un párrafo. La salida está restringida a las opciones que tú definiste de antemano, así que el modelo no puede inventar una categoría que no existía ni equivocar el tipo de un campo. TypeSafe lo resume en una frase que vale la pena retener: Jev no puede alucinar y no comete errores de tipo, porque la estructura de la respuesta se define antes de hacer la pregunta (fuente).
Esto lo convierte en una pieza distinta dentro de una arquitectura. Un chatbot se sienta frente a una persona; Jev se sienta dentro de tu software, en el punto donde hoy escribirías un if con reglas frágiles o harías una llamada completa a un LLM de frontera.
Las tres primitivas: Noul, Choice y Score
Jev solo sabe responder de tres maneras, y con eso cubre la mayoría de las decisiones que una aplicación necesita automatizar. La documentación las llama primitivas y son composables: puedes mezclarlas en una sola llamada.
| Primitiva | Qué responde | Qué devuelve | Ejemplo |
|---|---|---|---|
| Noul | ¿Esto es cierto? (sí/no) | noul de 0 a 1 | ¿El mensaje expresa urgencia? |
| Choice | ¿Cuál de estas opciones? | choice, probabilities, confidence | ¿A qué equipo derivo este ticket? |
| Score | ¿En qué nivel está? | score, legend, probabilities, confidence | ¿Qué tan frustrado está el cliente? |
Noul es la pregunta de sí o no, pero con un matiz importante: la respuesta no es “sí” o “no”, es una probabilidad entre 0 y 1. Un 0.95 significa 95% de certeza de que sí. Esa probabilidad es la señal útil: tu código puede aprobar automáticamente los casos claros y escalar los dudosos, que es exactamente el patrón que TypeSafe llama gate o guardrail.
Choice elige una opción de un conjunto que tú defines. Puede haber hasta 255 opciones, y la respuesta incluye la ganadora, la distribución de probabilidad completa y un valor de confianza que resume qué tan picuda está esa distribución. Sirve para enrutar tickets, clasificar tipos de documento o detectar lenguaje de programación.
Score coloca el estado en un espectro ordenado de 2 a 10 niveles que tú describes. A diferencia de una nota, devuelve un valor ponderado por probabilidad que puede caer entre dos niveles (un 1.4, por ejemplo), más la leyenda que mapea cada número a su descripción.
Una llamada real a la API
Todo se resuelve en un único endpoint: POST https://api.typesafe.ai/v1/systemone. Le mandas el state, el model y un mapa de questions; te devuelve un answer tipado por cada pregunta, bajo la misma clave que elegiste.
curl -X POST https://api.typesafe.ai/v1/systemone \ -H "Authorization: Bearer $TYPESAFE_API_KEY" \ -H "Content-Type: application/json" \ -d @- <<'EOF' { "state": "Llevo tres días intentando conectar mi cuenta de Stripe y la integración sigue fallando. Estoy perdiendo ventas.", "model": "jev-latest", "questions": { "departamento": { "type": "choice", "instructions": "¿Qué equipo debería atender este mensaje?", "criteria": { "facturacion": "Problemas de pagos o suscripción", "tecnico": "Bugs o problemas de integración", "ventas": "Precios o preguntas de cuenta" } }, "frustracion": { "type": "score", "instructions": "¿Qué tan frustrado parece el cliente?", "criteria": ["Tranquilo", "Frustrado", "Muy enojado"] }, "es_urgente": { "type": "noul", "instructions": "¿El mensaje transmite urgencia?" } } }EOFLa respuesta es directamente consumible por tu código:
{ "model": "jev-1.13.0", "answers": { "departamento": { "type": "choice", "choice": "tecnico", "confidence": 0.78, "probabilities": { "tecnico": 0.85, "ventas": 0.0, "facturacion": 0.15 } }, "frustracion": { "type": "score", "score": 1.0, "confidence": 1.0, "legend": { "0": "Tranquilo", "1": "Frustrado", "2": "Muy enojado" }, "probabilities": { "0": 0.0, "1": 1.0, "2": 0.0 } }, "es_urgente": { "type": "noul", "noul": 0.95 } }, "usage": { "input_tokens": 392, "output_tokens": 65 }}Y con el SDK de Python (también hay uno para JavaScript, @typesafe-ai/sdk), la misma llamada queda tipada de punta a punta:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient
ticket = "Llevo tres días intentando conectar mi cuenta de Stripe y la integración sigue fallando."
with TypeSafeClient() as client:    response = client.system_one(        state=ticket,        questions={            "departamento": Choice(                instructions="¿Qué equipo debería atender este mensaje?",                criteria={                    "facturacion": "Problemas de pagos o suscripción",                    "tecnico": "Bugs o problemas de integración",                    "ventas": "Precios o preguntas de cuenta",                },            ),            "es_urgente": Noul(instructions="¿El mensaje transmite urgencia?"),        },    )
print(response.answers["departamento"].choice)  # "tecnico"print(response.answers["es_urgente"].noul)      # 0.95
La clave de estos ejemplos está en la última línea de cualquier integración: el modelo propone, tu código ejecuta. Un choice mapea directo a una rama de código; un score mapea a un umbral; un noul mapea a un if. En ningún punto hay que leer prosa.
El estado es el contexto
Jev no es una enciclopedia ni un modelo de conocimiento general. Acepta texto, objetos JSON y arreglos, pero no sabe nada por sí mismo: todo lo que necesita para decidir lo pones en el state. Si quieres que enrute tickets entre facturación, soporte y ventas, esas categorías tienen que existir en tu petición, no en el peso del modelo.
Esa es la diferencia central con un LLM. El state es la información que el modelo evalúa, y las instructions de cada pregunta son dónde vive tu lógica de negocio. Puedes apuntar una pregunta a un campo concreto de un estado estructurado usando rutas con backticks, por ejemplo ¿El texto en \ticket.messages[0].text` solicita un reembolso?`. El modelo no rellena huecos con conocimiento general: mide qué tan cerca está tu pregunta de la información que le entregaste.
Hay un límite físico a tener en cuenta: el contexto por petición es de 64,000 tokens, con un presupuesto de 32,000 para el state más la pregunta más larga (fuente). No es el millón de tokens de un LLM de frontera; Jev es un modelo pequeño y enfocado, no un depósito de contexto.
Velocidad y costo
El argumento más fuerte de Jev no es lo que hace, sino a qué precio y a qué velocidad. La comparación oficial es directa:
| Dimensión | LLM de frontera | Jev (System One) |
|---|---|---|
| Entrada | $0.20–$10 / millón de tokens | $0.042 / millón de tokens |
| Salida | ~5× más cara que la entrada | Gratis (demasiado barata para medir) |
| Latencia | 3–329 s de punta a punta | 70–500 ms |
| Velocidad relativa | 40×–200× más rápido | |
| Confianza | Sobreconfiado e inconsistente | Calibrada en cada respuesta |
Los números de coste salen de la página de modelos (fuente); el rango de velocidad y la comparación de latencia están en el anuncio de lanzamiento (fuente).
La combinación es lo que abre casos que antes eran incómodos. Clasificar grandes volúmenes con un LLM siempre fue posible, pero lento y caro: el modelo lee un mensaje, genera texto, pasa al siguiente. Jev hace el mismo trabajo sin producir prosa, y esa diferencia se traduce directo en tiempo y en factura. Los límites de la API también apuntan en esa dirección: 250,000 tokens por segundo y 1,200 peticiones por minuto, aunque TypeSafe advierte que están ajustándose según la demanda (fuente).
Lo que Jev no hace
Respetar los límites es parte de usarlo bien, y TypeSafe es explícito al respecto.
No razona en cadenas largas. Si necesitas un análisis profundo, una argumentación o una respuesta elaborada, Jev no es el modelo: su terreno son juicios que una persona con criterio puede emitir en un par de segundos.
No es de conocimiento general. No está entrenado en dominios especializados ni pretende serlo. Si algo no está en el state, no lo va a inventar. Todo el contexto lo pones tú, por diseño.
No es un chat. No redacta artículos ni sostiene conversaciones. Es una pieza dentro de una arquitectura, no un asistente de escritorio.
No es de código abierto. El modelo se sirve como API alojada en los servidores de TypeSafe; lo que sí es abierto es el ecosistema que lo rodea: awesome-jev, jev-mcp, la integración con LangChain y adaptadores como system-one-adapter-python (fuente).
Cómo probarlo hoy
Jev está en acceso anticipado. Entras a la página de TypeSafe, te registras y pides acceso; según el anuncio, están sacando gente de la lista de espera lo más rápido que pueden (fuente).
Una vez dentro, hay tres caminos prácticos. El primero es el playground de la consola, donde pegas un state, armas tus preguntas y ves la respuesta tipada con sus probabilidades; desde ahí se genera la clave de API. El segundo es llamar al endpoint directamente o con los SDK oficiales, como en los ejemplos de arriba. El tercero es para quienes trabajan con agentes: TypeSafe publica un skill que deja que herramientas como Claude Code consulten Jev como una capacidad más.
# Con Claude Codeclaude plugin marketplace add typesafe-ai/skillsclaude plugin install typesafe@typesafe-ai
# Con otros agentesnpx skills add typesafe-ai/skills --skill typesafe-ai
Eso encaja con la idea de fondo: no se trata de reemplazar tu modelo de razonamiento, sino de darle una pieza rápida y barata para las decisiones del día a día. Jev también está disponible a través de gateways como OpenRouter, Vercel AI Gateway y Cloudflare, así que hay más de una forma de llegar a él sin atarte a una sola vía (fuente).
Qué significa esto para quien construye software
Para el usuario final, Jev no es una revolución: nadie nota la diferencia entre un chatbot que responde en dos segundos y uno que responde en medio segundo. Para quien construye, la diferencia es otra: pagar centavos en lugar de dólares por clasificar el mismo volumen, y poder meter una decisión de IA dentro de un bucle de alta frecuencia sin que la latencia lo destruya.
El lanzamiento apunta a un hueco real. Enrutar tickets, moderar contenido, calificar riesgos, guardar un guardarraíl antes de una llamada a una herramienta, compactar contexto, extraer campos de texto libre: son todos problemas donde lo que necesitas es una respuesta estructurada y rápida, no un párrafo bien redactado. La tesis de TypeSafe, resumida en su manifiesto, es que la inteligencia que se integra en software necesita una interfaz de la que el código pueda depender, y no un prompt cuya salida haya que adivinar.
En lo personal, lo que me parece más interesante no es Jev en sí, sino la categoría que abre. Los modelos de decisiones o de system one atacan un punto que los LLM, por diseño, resuelven mal: la certeza barata sobre datos que no siguen un patrón fijo. Si la idea funciona, es razonable esperar que otros laboratorios saquen modelos similares y que aparezcan más piezas open source alrededor del enfoque. No hay certeza sobre plazos, pero la dirección parece clara.
Conclusión
Jev no viene a quitarle el trabajo a tu modelo de razonamiento; viene a quitarle trabajo repetitivo. Es una pieza para las decisiones de alto volumen donde un LLM es fuerza bruta y una regla escrita a mano es demasiado frágil. Devuelve valores tipados con probabilidades calibradas, en decenas de milisegundos, a un costo marginal de salida gratis.
La decisión de usarlo, como siempre, depende de tu caso: si el problema es un juicio rápido y repetible sobre un contexto que tú controlas, Jev encaja. Si el problema exige razonamiento profundo o generación de texto, no es la herramienta. Saber distinguir entre ambos es, en el fondo, de lo que se trata construir software con IA.
Si estás construyendo con IA y tienes un proceso donde alguien clasifica, prioriza o decide a mano, en volumen, este es el tipo de herramienta que vale la pena evaluar. Si quieres analizar qué procesos de tu negocio podrían resolverse así, escríbeme por WhatsApp o visita mi página de contacto.
Fuentes y referencias
- Anuncio oficial: Introducing System One Models & Jev typesafe.ai/blog/introducing-system-one-models-and-jev
- Introducción a Jev y System One docs.typesafe.ai/introduction
- Concepto de System One docs.typesafe.ai/concepts/system-one
- Primitivas (Noul, Choice, Score) docs.typesafe.ai/primitives
- Modelos, precios y límites docs.typesafe.ai/models
- Referencia de la API (
POST /v1/systemone) docs.typesafe.ai/api - Quick start y SDKs docs.typesafe.ai/introduction/quickstart
- Skill para agentes docs.typesafe.ai/agent-skill
- Jev en Cloudflare AI developers.cloudflare.com/ai/models/typesafe/jev/