

Ricardo Vázquez no me llamó porque algo estuviera fallando.
Su clínica dental llevaba un par de meses usando un asistente virtual en su sitio web: un chatbot que atendía dudas de pacientes, explicaba servicios, y derivaba a WhatsApp cuando alguien quería agendar una cita. Funcionaba. Los pacientes lo usaban, las conversaciones fluían bien, y Ricardo estaba contento con el resultado.
El problema no estaba en lo que veían sus pacientes. Estaba en algo que casi nadie revisa: cuánto cuesta, por dentro, cada mensaje que ese chatbot responde.
Un asistente que “hablaba de más” en cada mensaje
Cuando entré a revisar el proyecto, lo primero que hice fue mirar el panel de uso de la API, no el chatbot en sí. Y ahí estaba la señal: el consumo de tokens por conversación era más alto de lo que debería, incluso para preguntas simples como “hola, ¿qué servicios ofrecen?”.
La causa no era ningún error de código. Era el system prompt: las instrucciones internas que le dicen al modelo de IA quién es, cómo debe comportarse, qué puede y no puede hacer. Ese texto se reenvía completo en cada mensaje de la conversación, porque así funciona un chatbot sin memoria persistente entre peticiones: no recuerda nada por sí solo, así que hay que recordárselo cada vez.
El system prompt de la clínica era extenso, con buena razón: describía todos los servicios dentales, el tono que debía usar el asistente, cómo manejar objeciones sobre precios, cómo derivar a contacto humano, y una serie de límites de seguridad para evitar que alguien lo manipulara y lo sacara de su rol. Nada de eso estaba de más. El problema era cómo estaba escrito, no qué decía.
Estaba redactado en español, con explicaciones largas y ejemplos repetidos que decían, en el fondo, lo mismo dos o tres veces. Cada una de esas palabras de más se traduce directamente en tokens, y cada token se traduce en costo, mensaje tras mensaje, día tras día.
Le expliqué a Ricardo que no era un problema hoy. Era un problema que se iba a hacer más caro entre más creciera su clínica y más gente usara el chatbot.
Esa es la parte que más le costó ver al principio: el asistente respondía bien, los pacientes quedaban satisfechos, todo se sentía “resuelto”. Pero un negocio que crece necesita que sus costos crezcan más lento que sus ingresos, no al mismo ritmo. Y ese chatbot, tal como estaba, iba a escalar mal.
La estrategia: medir antes de tocar nada
Antes de cambiar una sola línea, definí algo que considero no negociable en este tipo de trabajo: no optimizar a ojo. Sin datos reales, “optimizar” un system prompt es solo adivinar.
El plan tuvo tres pasos:
- Medir el consumo real, no estimado, usando el tokenizer oficial del proveedor de IA que usa la clínica, el mismo que se usa internamente para calcular el costo de cada petición. No una regla genérica de “caracteres entre cuatro”; el número exacto de tokens que realmente se factura.
- Reescribir el system prompt conservando el 100% del comportamiento: mismo tono, mismos servicios, mismas reglas de seguridad, mismo criterio para derivar a contacto humano. El objetivo nunca fue que el asistente hiciera menos o peor su trabajo, sino que dijera lo mismo con menos texto.
- Aprovechar cómo tokenizan los modelos de IA. Reescribí las instrucciones internas en inglés, el idioma en el que estos modelos fueron entrenados con más volumen de texto, manteniendo algo clave: el asistente sigue detectando y respondiendo automáticamente en el idioma del paciente. Un modelo no necesita que le digas “responde en español” para hacerlo; lo hace solo, porque responde en el idioma en el que le hablan. Esa instrucción de más también salió sobrando.
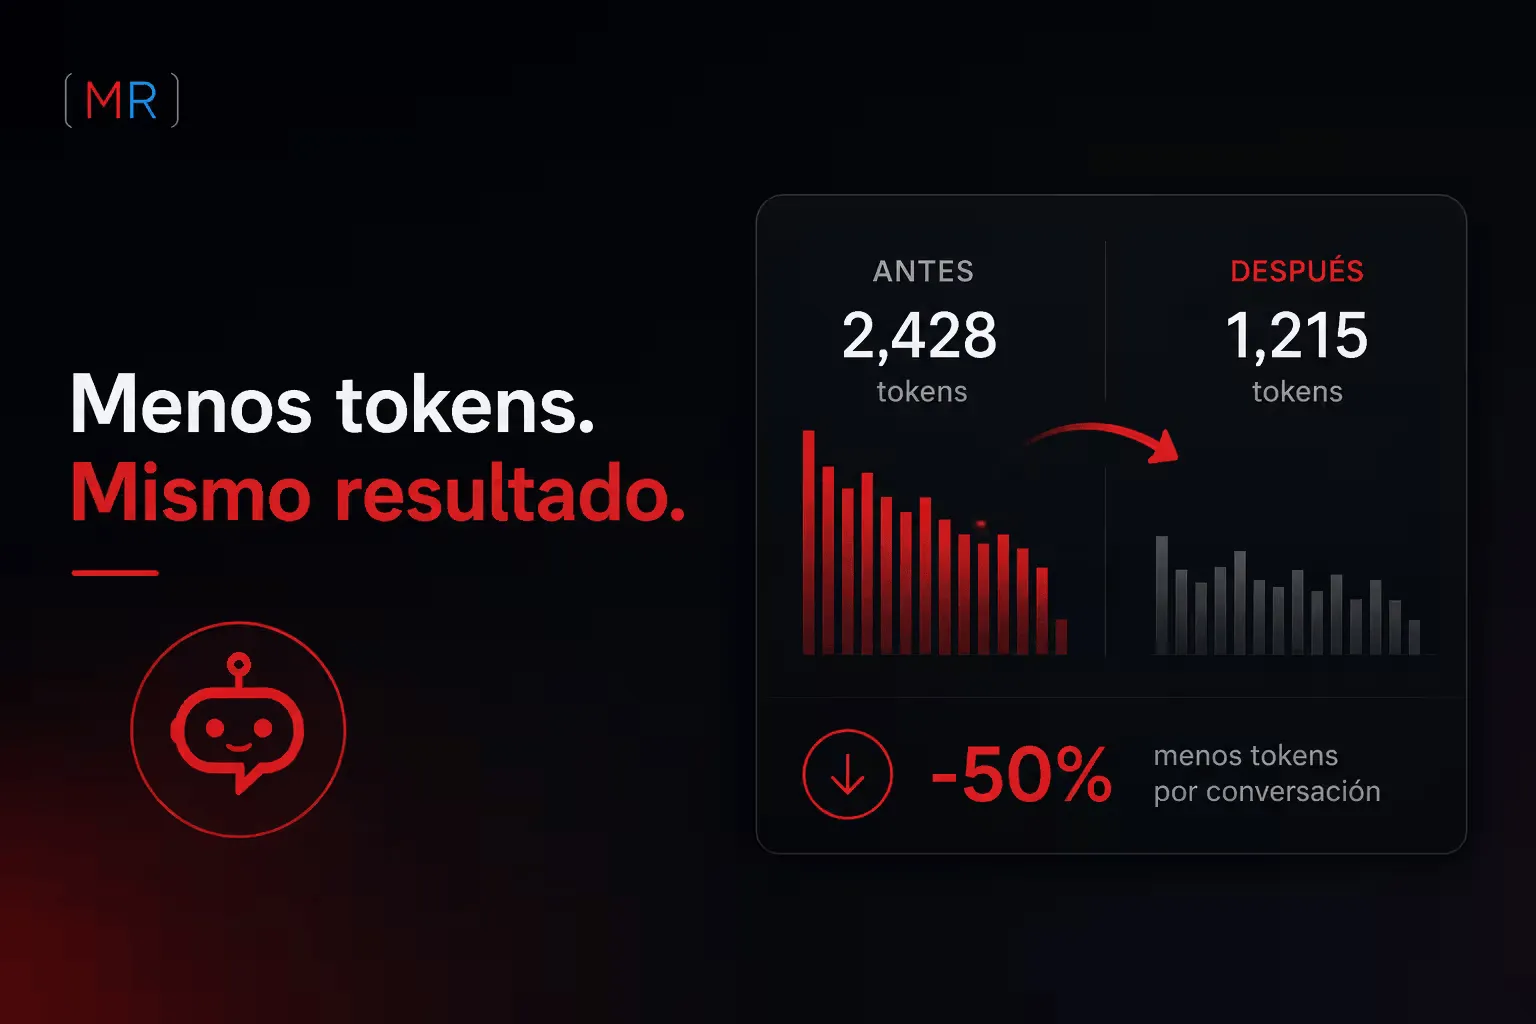
Nada de esto se lo prometí a Ricardo como una intuición. Antes de tocar producción, medí el prompt original y la versión nueva con el tokenizer real, lado a lado, para tener el número exacto de ahorro antes de subir nada.
El resultado, medido en producción real
Una vez que subimos la versión optimizada al sitio de la clínica, no me quedé con el número de laboratorio. Volví al panel de uso al día siguiente, aislé un mensaje real de un paciente probando el nuevo asistente, y comparé su consumo contra un mensaje equivalente de antes del cambio.
La reducción real, con tráfico real, fue de prácticamente la mitad de los tokens por conversación. Mismo asistente, mismas respuestas, mismo criterio para atender a un paciente, a un costo notablemente menor por cada intercambio.
Para una clínica que apenas estaba empezando a usar IA para atención al público, eso significa que el mismo presupuesto ahora rinde para el doble de conversaciones con pacientes. Y entre más crezca el uso del chatbot (más visitas al sitio, más pacientes preguntando por servicios, más temporadas de alta demanda) ese ahorro no se queda fijo: se multiplica con cada mensaje adicional que el negocio no tiene que pagar de más.
Cuando le mostré la comparación a Ricardo, me dijo que pensaba que la IA ya venía “optimizada” de fábrica. No sabía que la forma en que le escribes las instrucciones podía cambiar tanto el costo.
Por qué esto importa más allá de una clínica dental
Este caso no fue sobre arreglar algo roto. Fue sobre encontrar un costo silencioso antes de que se convirtiera en un problema real: el tipo de cosa que, si nadie la revisa a tiempo, un negocio solo nota meses después, cuando la factura del proveedor de IA empieza a subir sin que el número de pacientes atendidos haya cambiado mucho.
Cualquier negocio que integre un asistente de IA en su sitio (clínicas, comercios, despachos, restaurantes) tiene ese mismo riesgo escondido en su system prompt, sin importar qué tan bien “hable” el bot de cara al cliente. La experiencia del usuario y el costo interno son dos cosas distintas, y solo una de ellas se ve a simple vista.
¿Tienes un chatbot o asistente de IA funcionando en tu negocio y nunca has revisado qué tan eficiente es su costo real? Cuéntame cómo lo estás usando y lo revisamos juntos.