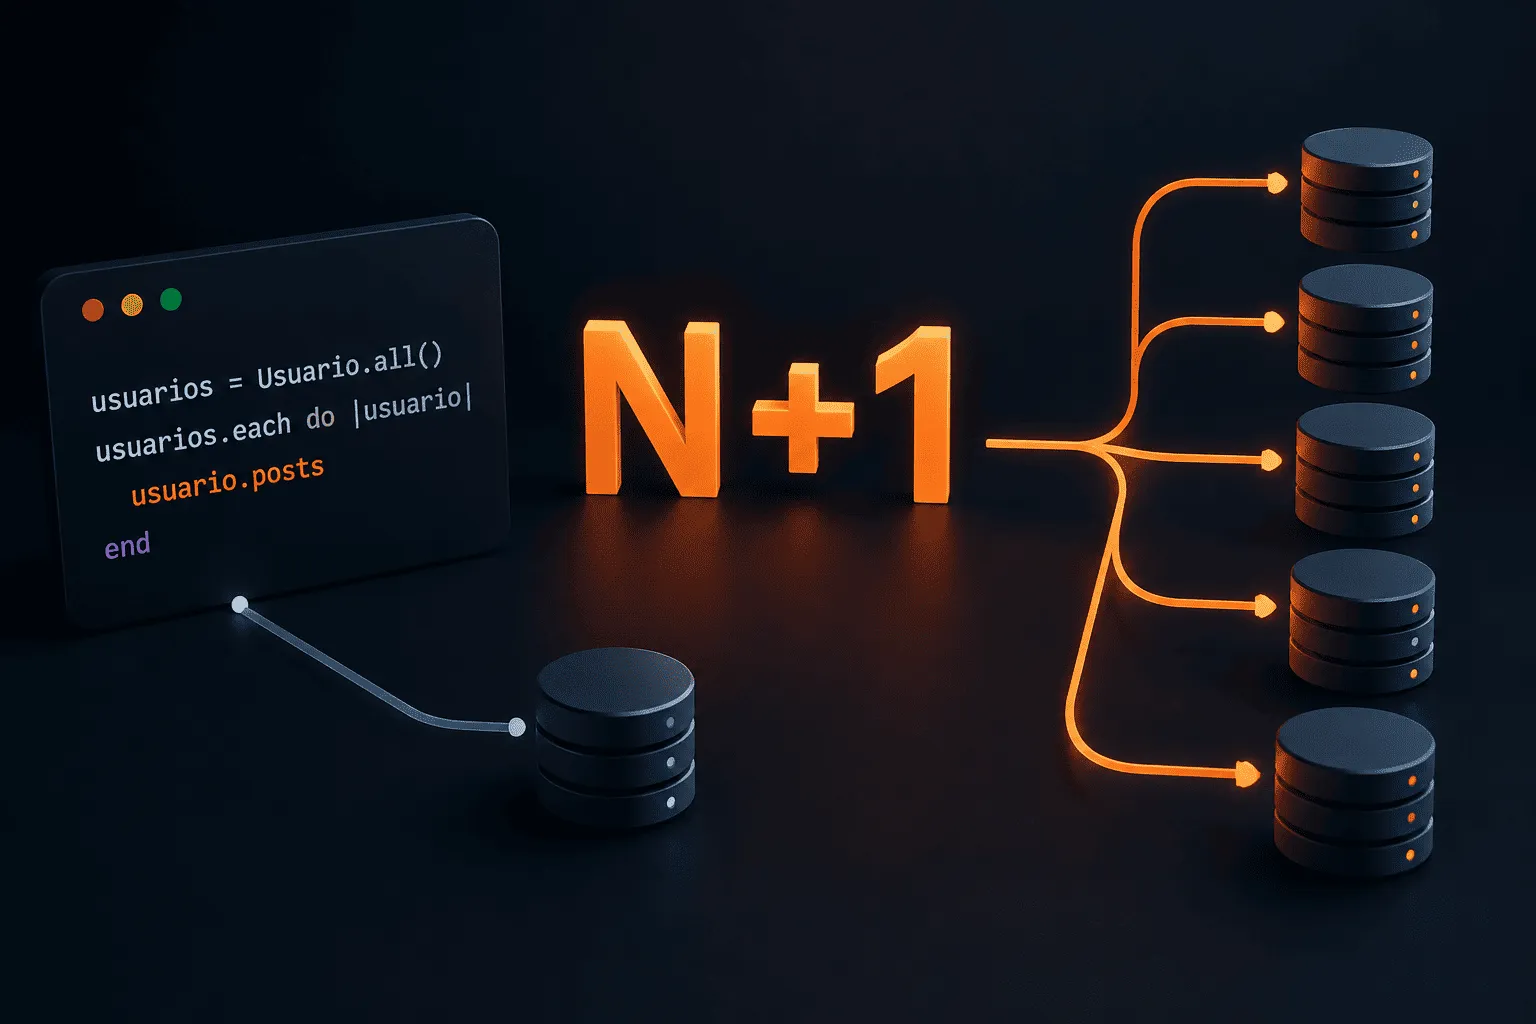


Una de las ventajas de utilizar un ORM es que podemos trabajar con relaciones entre entidades utilizando código que parece sencillo y natural.
El problema aparece cuando esa abstracción oculta el coste real de las operaciones que ejecutamos.
Una línea como “usuario.posts” puede parecer un simple acceso a una propiedad. Sin embargo, dependiendo de cómo esté configurado el ORM y de cómo se hayan cargado previamente las relaciones, ese acceso puede provocar una consulta adicional a la base de datos.
Cuando esto ocurre dentro de un bucle, aparece uno de los problemas de rendimiento más conocidos al trabajar con ORM: el problema N+1.
No suele ser un error de sintaxis. Tampoco necesariamente rompe la lógica de negocio. El código puede funcionar perfectamente y aun así generar cientos o miles de consultas innecesarias.
Y ahí está precisamente el peligro: la aplicación funciona, pero escala peor de lo que debería.
¿Qué es exactamente el problema N+1?
Supongamos que necesitamos mostrar una lista de usuarios junto con sus publicaciones.
Podríamos escribir algo parecido a esto:
usuarios = obtener_usuarios()
for usuario in usuarios: posts = usuario.posts
for post in posts: mostrar(post)El código parece razonable.
El problema aparece si “usuario.posts” utiliza lazy loading y la relación todavía no ha sido cargada.
La aplicación podría ejecutar primero:
SELECT * FROM users;
Y posteriormente una consulta por cada usuario:
SELECT * FROM posts WHERE user_id = 1; SELECT * FROM posts WHERE user_id = 2; SELECT * FROM posts WHERE user_id = 3; …
Si recuperamos 1.000 usuarios, podemos terminar ejecutando:
1 consulta inicial + 1.000 consultas adicionales = 1.001 consultas.
De ahí viene el nombre N+1:
- 1 consulta para obtener la colección principal.
- N consultas adicionales para obtener una relación por cada elemento.
El problema no es únicamente el tiempo de ejecución de cada consulta individual.
También existe un coste asociado a ejecutar muchas operaciones separadas: comunicación entre aplicación y base de datos, procesamiento de consultas, transferencia de resultados, planificación, serialización y otros costes que pueden acumularse.
La trampa está en la carga perezosa
El lazy loading o carga perezosa consiste en no recuperar una relación hasta que realmente se accede a ella.
Esto tiene sentido.
Si tenemos:
usuario = Usuario.find(1)
no necesariamente queremos cargar inmediatamente todos sus posts, comentarios, seguidores y demás relaciones.
La carga perezosa evita traer datos que quizá nunca utilizaremos.
El problema aparece cuando esa relación se utiliza repetidamente dentro de una iteración:
@usuarios.each do |usuario| usuario.posts.each do |post| puts post.title end end
Si “posts” no fue cargado previamente, cada usuario puede provocar una nueva consulta.
El código es limpio.
El SQL generado puede ser muy poco eficiente.
Esa diferencia entre lo que vemos en el código y lo que realmente ejecuta el ORM es una de las razones por las que el N+1 puede pasar desapercibido.
¿Por qué funciona bien en desarrollo?
Una de las razones por las que el problema N+1 llega a producción es que los entornos de desarrollo suelen trabajar con conjuntos de datos pequeños.
Con 10 usuarios:
- 1 consulta para usuarios.
- 10 consultas para posts.
- Total: 11 consultas.
Probablemente nadie lo note.
Con 1.000 usuarios:
- 1 consulta para usuarios.
- 1.000 consultas para posts.
- Total: 1.001 consultas.
La diferencia ya es considerable.
Y cuando además existen múltiples solicitudes concurrentes, el coste puede multiplicarse.
Por eso una aplicación puede parecer perfectamente rápida durante el desarrollo y degradarse cuando aumenta el volumen de datos o el tráfico.
Cómo detectar un N+1
La primera regla es sencilla:
no optimices suponiendo; mide.
Si sospechas que existe un N+1, observa las consultas que realmente ejecuta la aplicación.
Una señal típica es que el número de consultas aumente aproximadamente en función del número de elementos procesados.
Por ejemplo:
Registros| Consultas aproximadas 10 usuarios| 11 100 usuarios| 101 1.000 usuarios| 1.001
Este crecimiento es una señal de alerta.
En Rails existen herramientas como Bullet que pueden ayudar a detectar asociaciones utilizadas de forma ineficiente.
En Django puedes utilizar django-debug-toolbar para inspeccionar las consultas ejecutadas durante una petición.
También puedes analizar los logs del ORM, los registros de la base de datos o herramientas de observabilidad como New Relic.
La herramienta concreta importa menos que el principio:
«Si no sabes cuántas consultas ejecuta una operación, todavía no sabes realmente cuánto cuesta.»
La solución: eager loading
La solución habitual consiste en cargar las relaciones que sabemos que necesitaremos antes de recorrer los registros.
Esto se conoce como eager loading o carga anticipada.
Por ejemplo, en Rails:
@usuarios = Usuario.includes(:posts)
Después podemos recorrer las relaciones:
@usuarios.each do |usuario| usuario.posts.each do |post| puts post.title end end
En lugar de solicitar los posts individualmente para cada usuario, Rails puede cargar la asociación de forma anticipada.
Dependiendo de la estrategia utilizada, esto puede implicar varias consultas coordinadas o una consulta basada en JOIN.
Lo importante no es asumir que “includes” siempre significa un JOIN.
Lo importante es que dejamos de ejecutar una consulta independiente por cada usuario.
Cada ORM tiene su propia estrategia
El concepto es el mismo, aunque la API cambia dependiendo del framework:
Framework| Estrategia habitual Ruby on Rails| “includes(:posts)” Django| “prefetch_related(“posts”)” Hibernate| “JOIN FETCH” Laravel| “with(“posts”)” Entity Framework| “Include(x => x.Posts)”
Pero hay una consideración importante:
estas herramientas no son simplemente “palabras mágicas para hacer una consulta”.
Cada ORM tiene sus propias reglas sobre cómo resuelve las asociaciones.
Por eso conviene entender qué SQL termina ejecutándose.
Una consulta no siempre es mejor que dos
Aquí aparece un error común al aprender sobre N+1.
Es fácil concluir:
«“Si 1.001 consultas son malas, entonces una sola consulta siempre es mejor.”»
No necesariamente.
Una consulta enorme con múltiples JOIN puede producir una cantidad considerable de filas duplicadas debido a las combinaciones entre relaciones.
Por ejemplo, si un usuario tiene:
- 10 posts.
- 20 comentarios.
Un JOIN entre ambas relaciones puede producir muchas combinaciones de filas que después deben procesarse.
Por eso algunas estrategias de eager loading prefieren realizar varias consultas controladas en lugar de construir un JOIN gigantesco.
La métrica correcta no es:
“¿Cuántas consultas tengo?”
La pregunta correcta es:
“¿Cuánto trabajo estoy haciendo para obtener los datos que realmente necesito?”
Esto incluye:
- número de consultas;
- cantidad de filas devueltas;
- cantidad de datos transferidos;
- tiempo de ejecución;
- uso de CPU;
- memoria;
- índices utilizados;
- concurrencia;
- y coste total de la operación.
El otro extremo: eager loading de todo
También podemos caer en el problema contrario.
Supongamos que tenemos:
Usuario.includes(:posts, :comments, :followers, :likes)
Hemos eliminado varios posibles N+1.
Pero quizá nuestra página solamente necesitaba mostrar el nombre del usuario y sus últimos tres posts.
Ahora estamos cargando información que nunca utilizaremos.
Eso también es una forma de ineficiencia.
Eliminar N+1 no significa cargar todas las relaciones.
Significa diseñar la consulta de acuerdo con los datos que realmente necesita esa operación.
¿Y si tenemos millones de registros?
El problema N+1 no se resuelve intentando cargar millones de registros en memoria.
Si una aplicación necesita procesar una cantidad enorme de datos, normalmente debemos controlar el tamaño del conjunto de resultados.
Algunas estrategias habituales son:
- paginación;
- cursor-based pagination;
- “LIMIT”;
- procesamiento por lotes;
- índices adecuados;
- consultas específicas;
- selección únicamente de las columnas necesarias;
- réplicas de lectura cuando la arquitectura lo requiere;
- particionamiento en escenarios apropiados.
Por ejemplo, no es lo mismo:
SELECT * FROM users;
que:
SELECT id, name FROM users ORDER BY id LIMIT 50;
La base de datos puede trabajar con tablas que contienen millones de registros.
Eso no significa que nuestra aplicación deba intentar traer esos millones de registros a memoria.
La escala debe gestionarse tanto en la base de datos como en la aplicación.
Índices: importantes, pero no solucionan un N+1
Otra confusión frecuente es pensar que un índice elimina el problema.
Un índice puede hacer que esta consulta:
SELECT * FROM posts WHERE user_id = 123;
sea mucho más rápida.
Pero si ejecutamos esa consulta 1.000 veces, seguimos teniendo 1.000 consultas.
Un índice puede reducir el coste individual de una consulta.
El eager loading puede reducir la cantidad de consultas necesarias.
Son problemas relacionados con el rendimiento, pero no son exactamente el mismo problema.
ORM vs SQL manual
Entonces, ¿son peligrosos los ORM?
No.
Un ORM es una herramienta de abstracción.
Nos permite desarrollar más rápido, mantener modelos relacionados y reducir una gran cantidad de código repetitivo.
El problema aparece cuando la abstracción hace que olvidemos que debajo sigue existiendo una base de datos ejecutando consultas reales.
Por eso un desarrollador backend no debería limitarse a conocer la API del ORM.
También debería entender conceptos como:
- SQL;
- índices;
- JOIN;
- cardinalidad;
- planes de ejecución;
- transacciones;
- locks;
- paginación;
- eager loading;
- lazy loading;
- y coste de las consultas.
No necesitas escribir SQL manual para cada operación.
Pero sí necesitas ser capaz de mirar el SQL generado y entender qué está haciendo realmente tu aplicación.
Cómo pensar como un desarrollador backend
Cuando veas código como:
usuarios.each do |usuario| usuario.posts.each do |post| # … end end
no pienses solamente:
«“El código funciona.”»
Piensa también:
«“¿Cuántas consultas genera esto?”»
Y después:
«“¿Cuántas filas estoy recuperando?”»
Y finalmente:
«“¿Estoy recuperando exactamente los datos que necesito?”»
Ese cambio de mentalidad es mucho más importante que memorizar “includes”, “prefetch_related” o cualquier otra función concreta.
Las APIs cambian.
El principio permanece.
El N+1 no es un problema de sintaxis
El problema N+1 es especialmente interesante porque el código puede ser completamente correcto.
No necesariamente existe una excepción.
No necesariamente aparece un error en el debugger.
Los tests pueden pasar.
La aplicación puede funcionar.
Y aun así, una operación aparentemente sencilla puede estar generando cientos o miles de consultas.
Por eso el rendimiento debe considerarse una propiedad que se mide y observa, no algo que simplemente asumimos.
La próxima vez que una aplicación se vuelva lenta, no empieces automáticamente aumentando recursos del servidor.
Primero pregunta:
- ¿Cuántas consultas está ejecutando esta operación?
- ¿El número de consultas crece con la cantidad de registros?
- ¿Estoy provocando lazy loading dentro de un bucle?
- ¿Necesito eager loading?
- ¿Estoy cargando más datos de los necesarios?
- ¿Los filtros y relaciones utilizan índices adecuados?
- ¿Qué SQL está generando realmente mi ORM?
Si descubres que una página que muestra 100 usuarios está ejecutando 101, 201 o incluso más consultas, probablemente tienes un problema que merece investigación.
Y la solución no siempre será “hacer una consulta”.
Será hacer el trabajo correcto, en el lugar correcto y en la cantidad correcta.
Ese es el verdadero objetivo de optimizar una aplicación backend.
Si quieres analizar el rendimiento de tu aplicación, “hablemos” (https://miguelramos.net/#contacto). Podemos revisar las consultas que genera tu backend, identificar cuellos de botella y determinar qué optimizaciones tienen sentido antes de cambiar la arquitectura o aumentar infraestructura.