
Dos programas pueden resolver exactamente el mismo problema y, sin embargo, tener comportamientos completamente distintos.
Uno puede responder en milisegundos y otro tardar segundos cuando la cantidad de datos crece. La diferencia no siempre está en el lenguaje, el procesador o en escribir más código. Muchas veces empieza mucho antes: en la forma en que decidiste organizar la información.
Cuando programas, no trabajas únicamente con variables y funciones. Trabajas con conjuntos de datos que necesitan ser buscados, recorridos, modificados, ordenados o relacionados. La estructura que eliges determina qué operaciones son baratas y cuáles pueden convertirse en un cuello de botella.
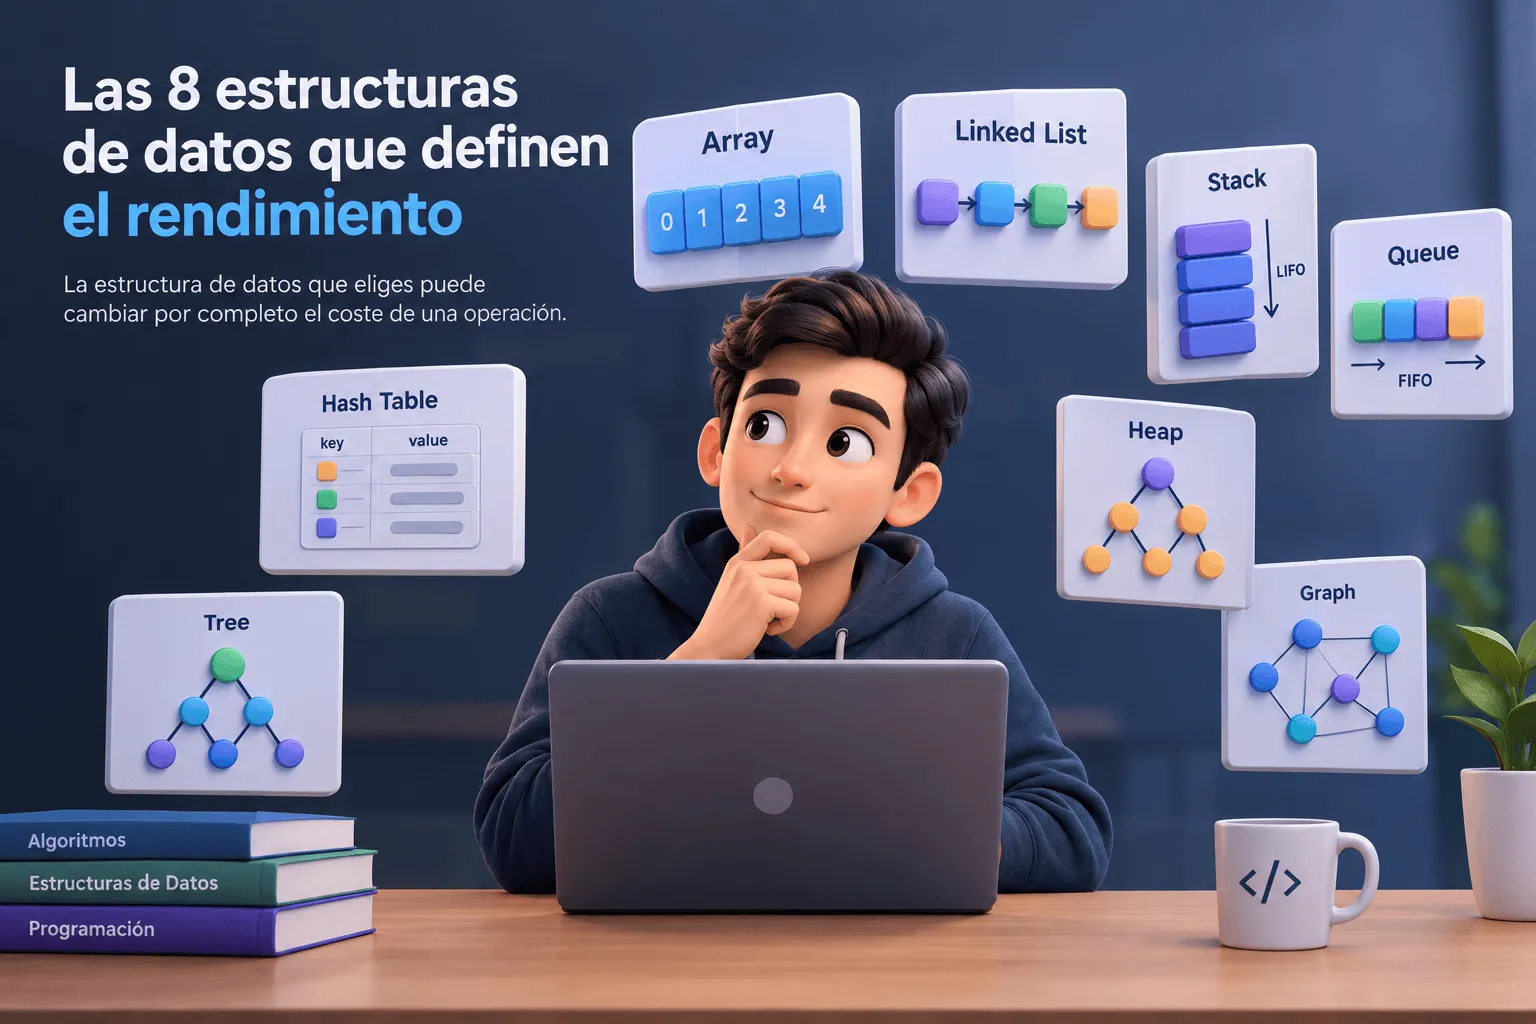
Por eso considero que aprender estructuras de datos no consiste en memorizar nombres como Array, Stack o Hash Table. Consiste en aprender a hacer una pregunta mucho más importante: ¿qué operación necesito hacer muchas veces y cómo puedo organizar los datos para que esa operación sea eficiente?
A continuación voy a recorrer ocho estructuras fundamentales y, sobre todo, cuándo tiene sentido utilizarlas.
Antes de elegir una estructura, piensa en la operación
No existe una estructura de datos universalmente “mejor”. Una estructura puede ser excelente para buscar por clave y pésima para mantener un orden concreto. Otra puede ser muy buena para insertar elementos al principio, pero mala para acceder directamente al elemento número 10 000.
Por eso conviene pensar primero en las operaciones que realizará tu programa.
| Estructura | Acceso / consulta típica | Inserción | Eliminación | Uso característico |
|---|---|---|---|---|
| Array | O(1) por índice | O(n) en posiciones intermedias | O(n) | Datos secuenciales |
| Linked List | O(n) | O(1) con referencia al nodo | O(1) con referencia al nodo | Inserciones y eliminaciones |
| Stack | O(1) en el tope | O(1) | O(1) | LIFO, deshacer, llamadas |
| Queue | O(1) en extremos | O(1) | O(1) | Procesamiento por orden |
| Hash Table | O(1) promedio | O(1) promedio | O(1) promedio | Búsqueda por clave |
| Tree | O(log n) si está balanceado | O(log n) si está balanceado | O(log n) si está balanceado | Datos jerárquicos |
| Heap | O(1) para consultar prioridad | O(log n) | O(log n) | Colas de prioridad |
| Graph | Depende de la representación | Depende | Depende | Relaciones y redes |
Estos valores son complejidades típicas, no garantías universales. La implementación concreta, el estado de la estructura y el patrón de acceso pueden cambiar el resultado.
El Array destaca cuando necesitas acceso directo
Un array almacena sus elementos de forma que permite acceder directamente a una posición mediante un índice.
Puedes imaginarlo como una fila de casilleros numerados. Si necesitas el elemento que está en la posición 747, no tienes que revisar los anteriores: puedes calcular dónde se encuentra y acceder directamente.
Por eso el acceso por índice suele ser O(1).
La situación cambia cuando necesitas insertar o eliminar un elemento en medio. Si la estructura necesita mantener los elementos consecutivos, los elementos posteriores pueden tener que desplazarse.
const coches: string[] = [  "Toyota",  "Mazda",  "Ford",  "BMW",  "Audi"];
// Acceso por índice: O(1)console.log(coches[2]); // "Ford"
// Inserción en medio: O(n) en un array dinámicocoches.splice(1, 0, "Honda");
console.log(coches);// ["Toyota", "Honda", "Mazda", "Ford", "BMW", "Audi"]
Esto hace que los arrays sean una opción excelente cuando accedes frecuentemente por posición y no necesitas insertar elementos constantemente en posiciones intermedias.
En la práctica, además, los arrays suelen beneficiarse de un buen comportamiento de caché de CPU porque sus elementos están organizados de manera contigua o con una representación optimizada por la implementación.
Una Linked List cambia acceso directo por flexibilidad
Una lista enlazada organiza los datos mediante nodos. Cada nodo contiene un valor y una referencia hacia otro nodo.
En lugar de imaginar casilleros consecutivos, imagina una búsqueda del tesoro: cada pista te indica dónde encontrar la siguiente.
La ventaja aparece al insertar o eliminar un nodo cuando ya tienes una referencia al lugar donde realizar la operación. No necesitas desplazar todos los elementos posteriores como ocurre con un array.
La desventaja es precisamente el acceso. Si quieres encontrar el elemento número 500, normalmente debes comenzar desde el principio y recorrer los nodos anteriores.
Por eso el acceso por posición es O(n), mientras que una inserción o eliminación puede ser O(1) cuando ya conoces el nodo o la posición relevante.
Las listas enlazadas tienen aplicaciones específicas, aunque en lenguajes modernos muchas veces un array dinámico ofrece mejor rendimiento general debido a su localidad de memoria.
La lección importante no es “usa Linked Lists para insertar”. Es entender qué información necesitas tener disponible para que esa inserción sea realmente barata.
El Stack resuelve problemas donde el orden importa
Una pila, o Stack, sigue el principio LIFO: Last In, First Out.
El último elemento que entra es el primero que sale.
La analogía clásica es una pila de platos. Si colocas un plato encima de los demás, no vas a sacar uno que esté en medio: primero tienes que retirar los que están encima.
Las operaciones principales son:
push: agregar un elemento.pop: retirar el elemento superior.peek: consultar el elemento superior sin retirarlo.
Cuando estas operaciones se realizan sobre el extremo adecuado, normalmente tienen coste O(1).
const pilaAcciones: string[] = [];
pilaAcciones.push("Escribir hola");pilaAcciones.push("Escribir mundo");pilaAcciones.push("Poner negrita");
const ultimaAccion = pilaAcciones.pop();
console.log(ultimaAccion);// "Poner negrita"
console.log(pilaAcciones);// ["Escribir hola", "Escribir mundo"]
Este comportamiento aparece en sistemas de deshacer, recorridos de estructuras, evaluación de expresiones y en el call stack, que mantiene información relacionada con las llamadas activas de funciones.
Cuando una aplicación recursiva consume más espacio del disponible para esa pila de llamadas, puede aparecer el conocido Stack Overflow.
La Queue procesa elementos respetando el orden de llegada
Una cola, o Queue, funciona al contrario: sigue el principio FIFO: First In, First Out.
El primero que entra es el primero que sale.
Es el modelo de una fila. Si llegan tres tareas en este orden:
Tarea A → Tarea B → Tarea Cla cola las procesa así:
Tarea A → Tarea B → Tarea CEsto resulta útil cuando no quieres que una tarea nueva salte delante de las anteriores.
Las colas aparecen en sistemas de procesamiento de trabajos, servidores, sistemas de mensajería, pipelines y tareas asíncronas.
Una implementación eficiente debe evitar mover todos los elementos cada vez que retiras el primero.
La Hash Table convierte claves en búsquedas eficientes
Una Hash Table, conocida en distintos lenguajes como Map, diccionario o tabla hash, está diseñada para encontrar información a partir de una clave.
En lugar de recorrer todos los registros buscando un email, por ejemplo, una función hash transforma esa clave en una posición asociada dentro de la estructura.
Por eso las operaciones de búsqueda, inserción y eliminación suelen tener un coste O(1) promedio.
interface Usuario { nombre: string; edad: number;}
const usuarios = new Map<string, Usuario>();
nombre: "Ana", edad: 25});
nombre: "Carlos", edad: 30});
// { nombre: "Ana", edad: 25 }La palabra importante aquí es promedio.
Una tabla hash puede sufrir colisiones cuando diferentes claves terminan asociadas a la misma posición. Las implementaciones modernas utilizan distintas estrategias para resolverlas y mantener un buen rendimiento, pero no debes interpretar O(1) como una garantía física de que todas las búsquedas tardarán exactamente lo mismo.
Una situación típica es almacenar una relación entre identificadores y objetos:
const contador: Record<string, number> = {};
const texto = "hola mundo hola";
for (const palabra of texto.split(" ")) {  contador[palabra] = (contador[palabra] ?? 0) + 1;}
console.log(contador);// { hola: 2, mundo: 1 }
La idea fundamental es sencilla: si tienes una clave adecuada, puedes evitar recorrer toda la colección para encontrar el valor asociado.
Los Trees representan información jerárquica
Un árbol organiza los datos mediante relaciones entre nodos padre e hijos.
La estructura aparece de forma natural cuando los datos tienen jerarquía:
Sistema├── Documentos│ ├── Trabajo│ └── Personal└── Imágenes ├── Viajes └── FamiliaPero los árboles no sirven únicamente para representar carpetas.
Un Binary Search Tree, por ejemplo, mantiene una regla de orden: los valores menores se colocan a un lado y los mayores al otro.
Si el árbol está correctamente balanceado, una búsqueda puede descartar grandes partes del conjunto en cada paso. En ese escenario, las operaciones pueden acercarse a O(log n).
El problema es que un árbol binario de búsqueda puede degradarse si los elementos se insertan en un orden desfavorable.
Árbol balanceado:
       8      / \     4   12    / \  / \   2  6 10 14

Árbol degenerado:
2 \  4   \    6     \      8
El segundo se parece más a una lista enlazada que a un árbol equilibrado.
Por eso existen estructuras como AVL Trees y Red-Black Trees, que incorporan mecanismos para mantener el árbol balanceado.
Los árboles también aparecen en parsers, sistemas de archivos, motores de búsqueda, índices y estructuras internas de diferentes herramientas de software.
El Heap mantiene la prioridad sin ordenar todo
Un Heap es un árbol especializado en gestionar prioridades.
A diferencia de una colección completamente ordenada, un Heap no necesita mantener todos sus elementos en orden absoluto. Su objetivo es garantizar que el elemento prioritario pueda obtenerse eficientemente.
Existen principalmente dos variantes:
- Min-Heap: el elemento mínimo queda en la raíz.
- Max-Heap: el elemento máximo queda en la raíz.
Esto resulta especialmente útil cuando constantemente necesitas preguntar:
¿Cuál es el siguiente elemento con mayor prioridad?
Por ejemplo, una cola de prioridad puede utilizar un Heap para decidir qué tarea debe procesarse primero.
Las operaciones habituales tienen estas características:
| Operación | Complejidad típica |
|---|---|
| Consultar la raíz | O(1) |
| Insertar | O(log n) |
| Extraer la raíz | O(log n) |
Esta estructura aparece en algoritmos como Dijkstra y en diferentes sistemas que necesitan gestionar prioridades.
Los Graphs modelan relaciones entre objetos
Un grafo representa entidades y las relaciones entre ellas.
Los puntos son nodos y las conexiones son aristas.
Ana / \ Luis Carlos \ / \ / MiguelEsta representación permite modelar problemas que no encajan naturalmente en una estructura lineal o jerárquica.
Una red social puede representarse como un grafo:
Persona → PersonaUn mapa puede representarse como:
Intersección → Calle → IntersecciónY una dependencia entre paquetes puede representarse como:
Aplicación → Librería A → Librería BLos grafos pueden ser dirigidos o no dirigidos. También pueden tener pesos asociados a sus conexiones, como distancia, coste o tiempo.
Para recorrerlos existen algoritmos fundamentales como BFS (Breadth-First Search) y DFS (Depth-First Search).
BFS explora por niveles:
Nivel 0: A |Nivel 1: B C / \Nivel 2: D EEsto resulta especialmente útil cuando quieres encontrar caminos en términos de número de conexiones, mientras que DFS profundiza por una rama antes de regresar para explorar otra.
La estructura correcta depende del patrón de acceso
Las ocho estructuras anteriores no compiten en una carrera para decidir cuál es “la mejor”.
Cada una está optimizada alrededor de determinadas operaciones.
Si necesitas acceso frecuente por posición, un Array tiene mucho sentido.
Si necesitas procesar elementos en orden de llegada, una Queue encaja naturalmente.
Si necesitas revertir el orden de las últimas operaciones, un Stack es una solución mucho más directa.
Si necesitas encontrar rápidamente un valor a partir de una clave, una Hash Table suele ser una excelente opción.
Si tus datos tienen jerarquía, un Tree puede representar esa relación de forma natural.
Si necesitas mantener una prioridad y extraer repetidamente el elemento prioritario, un Heap puede ser más apropiado que ordenar toda la colección.
Y cuando el problema consiste principalmente en relaciones entre entidades, un Graph ofrece un modelo mucho más expresivo.
Qué significa realmente que algo sea O(n)
La notación Big O no mide directamente cuántos milisegundos tarda un programa.
Describe cómo puede crecer el coste de una operación cuando aumenta el tamaño de la entrada.
Por ejemplo:
O(1) → el coste no crece con n de la misma manera que una operación linealO(log n) → crece lentamenteO(n) → crece proporcionalmenteO(n log n) → aparece con frecuencia en algoritmos eficientes de ordenamientoO(n²) → puede crecer rápidamente cuando n aumentaEsto es importante porque una mejora algorítmica no significa necesariamente que un programa pase mágicamente de segundos a milisegundos.
El hardware, la implementación, la memoria, la caché, el lenguaje, la cantidad de datos y el patrón real de ejecución también importan.
Big O sirve para razonar sobre el crecimiento del coste. No es un cronómetro.
Qué estructura elegir en un proyecto real
Cuando estoy diseñando una funcionalidad, intento no empezar preguntándome qué estructura “se ve más avanzada”.
Empiezo por las operaciones.
Si necesito acceder por posición:
ArraySi necesito trabajar con el último elemento añadido:
StackSi necesito procesar en orden de llegada:
QueueSi necesito buscar por una clave:
Hash TableSi necesito representar jerarquías:
TreeSi necesito obtener continuamente el elemento prioritario:
HeapSi necesito representar relaciones complejas:
GraphY si necesito muchas inserciones o eliminaciones con referencias directas a nodos:
Linked ListLa decisión final puede ser más compleja, pero este pequeño mapa mental ya evita muchas elecciones equivocadas.
Conclusión
Las estructuras de datos son una de esas partes de la programación que pueden parecer puramente académicas hasta que un proyecto empieza a crecer.
Cuando tienes pocos datos, muchas decisiones parecen funcionar.
Cuando la cantidad de información aumenta, las diferencias comienzan a importar.
Un Array, una Hash Table, un Tree o un Graph no son simplemente diferentes formas de guardar información. Son diferentes maneras de hacer que determinadas operaciones sean fáciles y otras más costosas.
Por eso, para mí, aprender estructuras de datos no consiste en memorizar una lista para aprobar una entrevista técnica. Consiste en desarrollar criterio.
La próxima vez que una funcionalidad sea lenta, antes de añadir más optimizaciones, pregúntate:
¿Estoy utilizando la estructura de datos adecuada para el trabajo que realmente necesito hacer?
Esa pregunta puede ser mucho más importante que escribir cien líneas adicionales de código.
Si estás construyendo un proyecto y necesitas convertir un proceso manual en software, puedo ayudarte a diseñar una solución a medida. Contacta conmigo aquí o escríbeme directamente por WhatsApp.