
Hay una escena que se repite cada vez más en el desarrollo de software: alguien pasa la tarde configurando skills, conectando MCPs, diseñando memoria y orquestando subagentes. Al terminar, siente que avanzó muchísimo, aunque todavía no haya construido la funcionalidad que necesitaba.
No necesariamente perdió el tiempo. Quizá aprendió cómo funciona su herramienta o creó infraestructura que reutilizará después. El problema aparece cuando confunde ese aprendizaje o esa sensación de control con productividad comprobada.
La pregunta incómoda es sencilla: ¿la fábrica está produciendo más software útil o solo estamos construyendo una fábrica cada vez más sofisticada?
Un ensayo controlado con desarrolladores experimentados encontró una brecha llamativa entre percepción y resultado: cuando podían utilizar herramientas de IA, tardaron un 19% más, aunque al finalizar creían que habían sido un 20% más rápidos. El hallazgo no demuestra que la IA perjudique siempre; demuestra algo más útil: usarla no garantiza ahorrar tiempo.
El arnés convierte un modelo en una herramienta
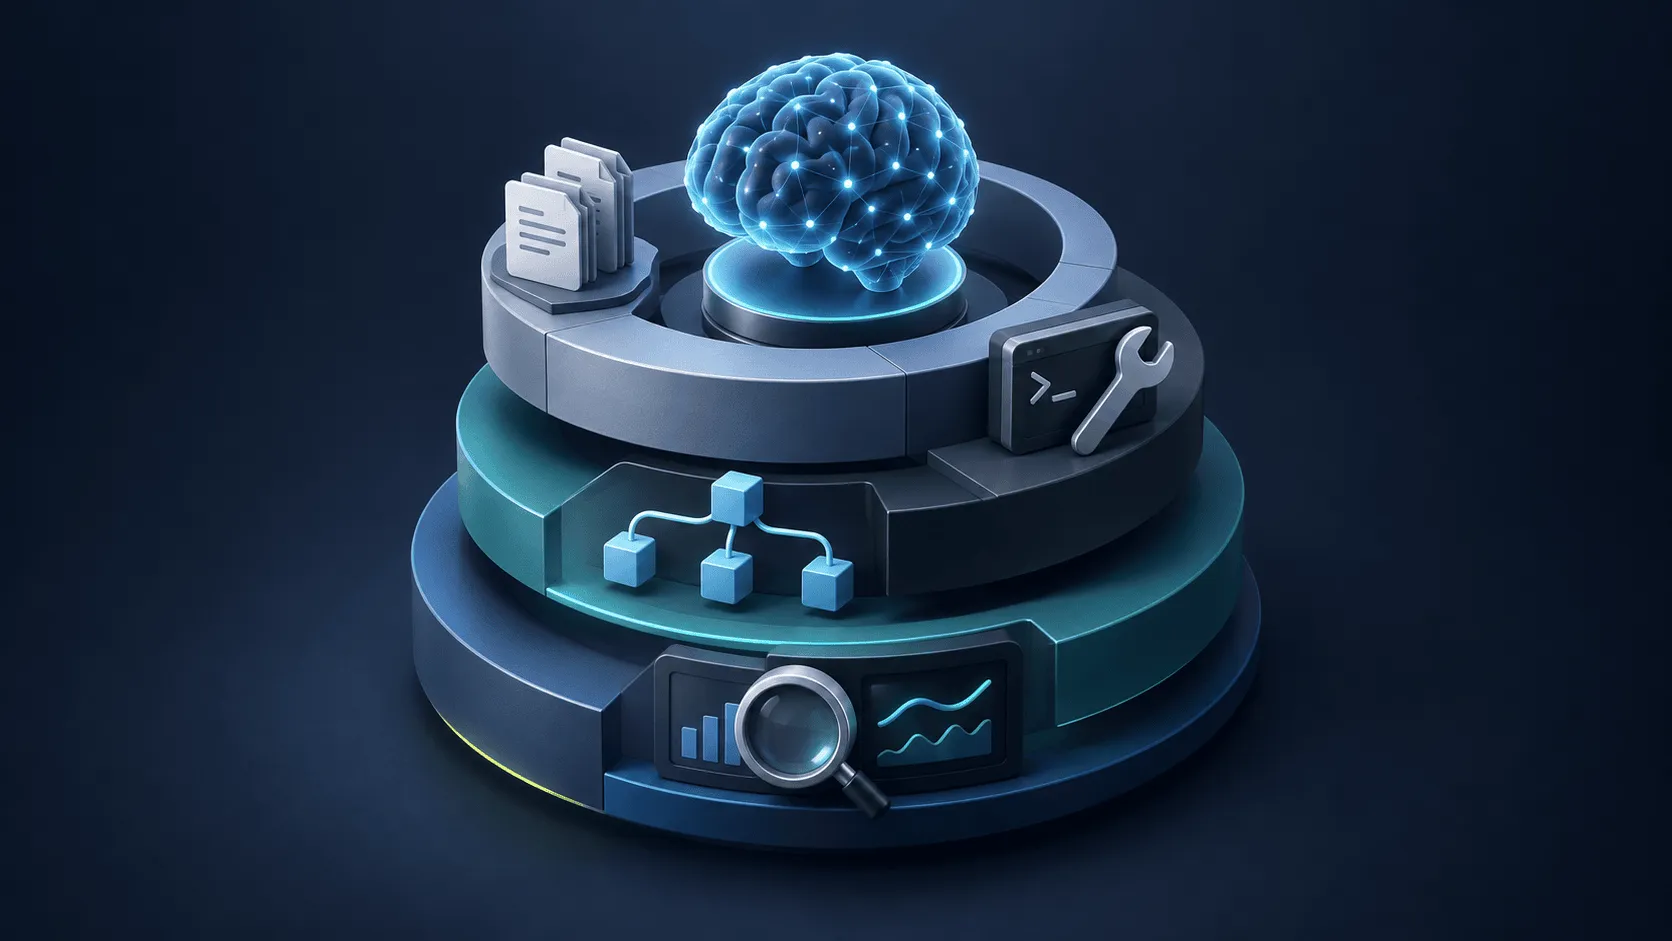
Un modelo de lenguaje puede decidir qué quiere hacer y generar una respuesta, pero necesita una capa externa para actuar sobre un sistema real. Esa capa el arnés o harness administra el contexto, expone herramientas, valida permisos, ejecuta acciones y devuelve los resultados al modelo.
Si un agente necesita leer un archivo, el modelo solicita la acción y el arnés se comunica con el sistema de archivos. Si necesita ejecutar una prueba, el arnés controla la operación, recoge la salida y la incorpora al siguiente paso del razonamiento.
En términos prácticos:
| Componente | Responsabilidad |
|---|---|
| Modelo | Interpreta, decide y genera |
| Contexto | Aporta reglas, código y conocimiento relevante |
| Herramientas | Permiten leer, buscar, ejecutar o modificar |
| Orquestación | Decide el orden, los límites y los reintentos |
| Observabilidad | Registra qué ocurrió, cuánto costó y dónde falló |
Por eso el mismo modelo puede rendir de manera distinta en dos productos. No cambia únicamente la inteligencia disponible; cambia la forma en que se le entrega información y se le permite actuar.
Configurar el entorno no siempre significa producir más
Los desarrolladores llevamos décadas personalizando nuestras herramientas. Neovim, Emacs, terminales, temas, atajos y archivos de configuración pueden convertirse en proyectos paralelos. No hay nada malo en ello: es entretenido, enseña y permite adaptar el entorno a la forma de trabajar de cada persona.
Pero aprendizaje, comodidad y productividad no son sinónimos.
Alguien que domina WebStorm quizá tarde semanas en recuperar con Neovim la velocidad que ya tenía. Esa inversión puede valer la pena por control, curiosidad o preferencia personal, aunque no produzca un retorno inmediato. El error no es personalizar; es justificar automáticamente cada personalización como una mejora de rendimiento.
Con los agentes de IA esta confusión resulta más fácil porque cada capa viene acompañada de una promesa: más autonomía, más memoria, mejores respuestas o menos trabajo manual. La promesa debe medirse contra el resultado, no contra lo impresionante que se ve la configuración.
El estudio que separó percepción y resultado
En 2025, investigadores de METR realizaron un ensayo controlado aleatorizado para estudiar herramientas de IA en condiciones más cercanas al trabajo real. Participaron 16 desarrolladores con experiencia en proyectos open source. En conjunto completaron 246 tareas de repositorios maduros en los que acumulaban, en promedio, cinco años de experiencia.
Cada tarea se asignó al azar a una de dos condiciones: permitir o impedir el uso de herramientas de IA. Cuando podían utilizarlas, los participantes trabajaron principalmente con Cursor Pro y Claude 3.5 o 3.7 Sonnet.
| Medición | Resultado promedio |
|---|---|
| Aceleración esperada antes de trabajar | 24% más rápidos |
| Aceleración percibida después de trabajar | 20% más rápidos |
| Resultado observado | 19% más lentos |
La diferencia es importante. Antes del experimento, los participantes esperaban que la IA redujera el tiempo de resolución un 24%. Incluso después de usarla, estimaron que les había ahorrado un 20%. Sin embargo, los tiempos observados mostraron que tardaron un 19% más.
El estudio no identifica una única causa definitiva. Evalúa varias explicaciones posibles: la familiaridad de los desarrolladores con sus repositorios, el tiempo dedicado a revisar y corregir resultados, la calidad exigida por proyectos maduros y las limitaciones de las herramientas disponibles a comienzos de 2025.
También importa el conocimiento tácito. Quien mantiene un proyecto desde hace años puede reconocer un fallo y saber qué archivo, función o supuesto revisar. Un agente debe reconstruir parte de ese mapa leyendo el repositorio, buscando referencias y comprobando hipótesis. Para una tarea pequeña, el coste de adquirir contexto puede ser mayor que el de aplicar directamente una solución conocida.
Cómo una limitación termina convertida en cinco capas
La sobreingeniería rara vez empieza como un capricho. Suele comenzar con un fallo real.
El agente ignora una convención, así que añadimos un archivo de instrucciones. Olvida una decisión, así que conectamos memoria. No encuentra información externa, así que añadimos un MCP. Una tarea parece grande, así que incorporamos subagentes. Después necesitamos saber qué hicieron esos subagentes, por lo que agregamos trazas y paneles.
Cada decisión puede ser razonable de forma aislada. El problema aparece en la acumulación:
- Surge una limitación concreta.
- Añadimos una capa para compensarla.
- La nueva capa introduce coste y comportamiento propios.
- Creamos otra capa para controlar la anterior.
- El sistema termina necesitando mantenimiento independiente.
Mientras tanto, los productos base también evolucionan. Capacidades que antes exigían extensiones memoria, planificación, ejecución en paralelo o agentes secundarios pueden terminar integradas en la herramienta principal. Parte de la configuración personalizada queda duplicada u obsoleta, pero permanece porque nadie vuelve a cuestionarla.
Criterio práctico: una configuración antigua no demuestra que siga siendo necesaria; solo demuestra que alguna vez resolvió un problema.
El mercado premia añadir, no simplificar
Alrededor de los agentes ha crecido un ecosistema de editores, CLIs, gateways, conectores, plataformas de observabilidad y catálogos de skills. Ese crecimiento facilita construir sistemas antes imposibles, pero también genera presión para adoptar cada novedad.
La mayoría de las demostraciones enseñan qué puedes añadir. Pocas muestran cuánto tarda el equipo en aprenderlo, cuántos tokens consume, qué riesgo incorpora o qué porcentaje de tareas mejora realmente.
Por eso eliminé de este análisis una comparación vistosa que circula sobre el tamaño futuro del mercado de herramientas de desarrollo frente al de los preservativos. Sin una fuente primaria clara y una definición comparable de ambos mercados, el dato distrae más de lo que explica. No necesitamos una cifra dudosa para reconocer el incentivo económico: cada nueva capa también es un producto que alguien quiere vender.
Los roles humanos no siempre son la mejor arquitectura
Otra tendencia consiste en reproducir un organigrama dentro del sistema: un agente de producto, otro de arquitectura, otro de programación, otro de pruebas y uno más que supervise a todos.
Esta división resulta intuitiva porque se parece a un equipo humano, pero esa familiaridad no demuestra que sea la mejor organización para modelos probabilísticos. Cada traspaso añade contexto, latencia, tokens y oportunidades de malentendido. Además, varios agentes pueden producir más actividad sin aumentar la calidad de la respuesta final.
Según la tarea, existen al menos tres patrones razonables:
| Patrón | Cuándo puede servir | Coste principal |
|---|---|---|
| Un agente con herramientas | Tareas acotadas y flujo claro | Menor diversidad de enfoques |
| Agentes con roles distintos | Etapas realmente especializadas | Coordinación y pérdida de contexto |
| Réplicas del mismo agente | Comparar soluciones independientes | Consumo elevado de tokens |
Las réplicas aprovechan la variabilidad del modelo: varias instancias resuelven el mismo problema y una revisión posterior compara sus propuestas. Puede aportar diversidad sin inventar personalidades ni responsabilidades artificiales. Tampoco es una solución universal; multiplica el coste y solo compensa cuando el error es caro o existen varias rutas plausibles.
La arquitectura correcta no es la que contiene más agentes. Es la más pequeña que mejora de forma comprobable el resultado.
Sin observabilidad, no puedes saber qué está funcionando
Cuando un solo agente falla, todavía puedes revisar la conversación. Cuando intervienen herramientas, memoria, subagentes, reintentos y proveedores distintos, esa revisión deja de ser suficiente.
Un sistema agéntico serio debería permitir responder, como mínimo:
- qué modelo atendió cada paso;
- qué contexto recibió;
- qué herramientas invocó y con qué resultado;
- cuántos tokens, tiempo y dinero consumió;
- dónde pidió intervención humana;
- qué cambio produjo y qué pruebas lo validaron.
La observabilidad no elimina la complejidad, pero evita que quede escondida. Sin trazabilidad, una automatización puede parecer exitosa porque terminó, aunque haya repetido trabajo, usado un fallback más caro o generado una solución que después necesitó correcciones manuales.
Una prueba sencilla para medir el retorno
La mejor forma de distinguir infraestructura útil de configuración ornamental es compararla con una línea base. No necesitas un laboratorio; necesitas tareas parecidas y una medición consistente.
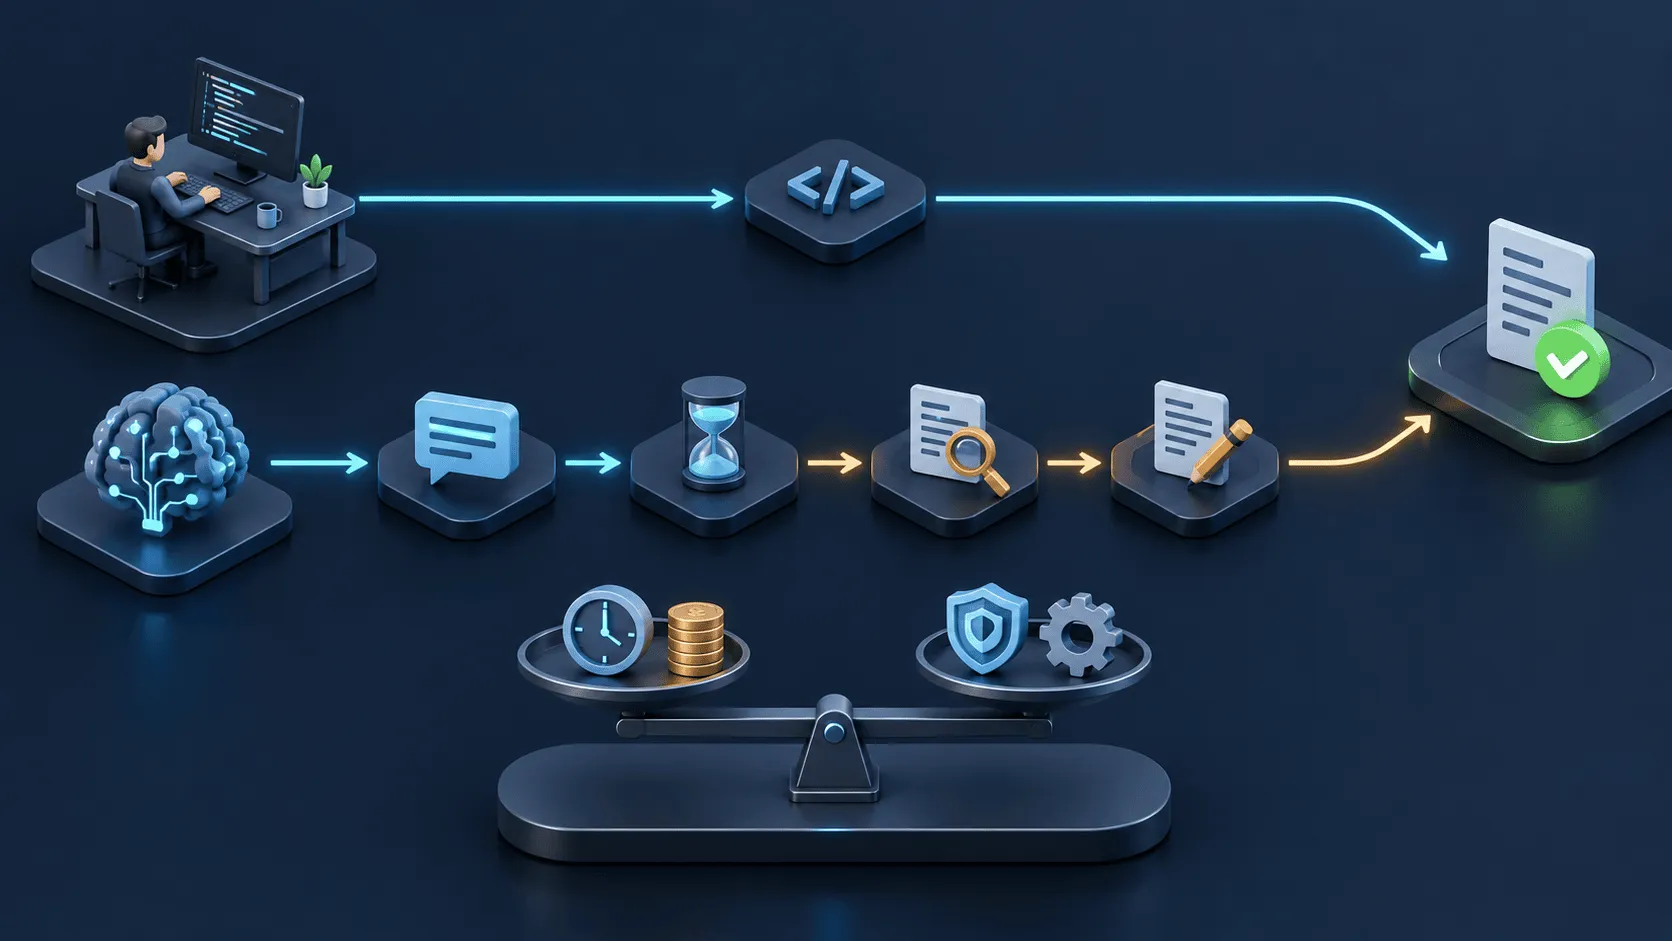
1. Define la unidad de trabajo
Elige tareas repetibles: corregir un bug pequeño, crear un endpoint, redactar pruebas o actualizar documentación. Evita comparar trabajos con dificultad radicalmente distinta.
2. Registra una línea base
Resuelve algunas tareas con el flujo más simple que ya dominas. Mide el tiempo total, no solo el tiempo de escritura.
3. Activa una sola capa
Añade una skill, un MCP, memoria o un agente secundario, pero no todo a la vez. Si cambias cinco variables, no sabrás cuál produjo el efecto.
4. Cuenta el trabajo oculto
Incluye el tiempo de configurar, esperar, revisar, corregir y depurar. También registra tokens, coste y errores que llegaron a etapas posteriores.
5. Compara calidad, no solo velocidad
Una solución más rápida que introduce regresiones no es más productiva. Usa pruebas, revisión de código y criterios de aceptación equivalentes.
| Señal | Pregunta de control |
|---|---|
| Tiempo total | ¿Terminaste antes después de revisar y corregir? |
| Calidad | ¿Pasó las mismas pruebas y criterios? |
| Coste | ¿Cuánto pagaste por obtener el resultado? |
| Carga cognitiva | ¿El trabajo fue más sostenible o solo más rápido? |
| Mantenimiento | ¿La nueva capa seguirá funcionando con la próxima versión? |
Qué haría si estuviera empezando
Empezaría con el agente tal como viene y añadiría una capacidad únicamente después de encontrar una limitación repetida. No instalaría cientos de skills de una vez porque no podría evaluar qué hace cada una, cuándo se activa ni qué permisos necesita.
Mi secuencia sería esta:
- Usar el flujo base en tareas reales.
- Documentar un problema que aparezca varias veces.
- Comprobar si la herramienta ya ofrece una solución nativa.
- Añadir la intervención más pequeña posible.
- Medirla contra el flujo anterior.
- Eliminarla si no produce una diferencia defendible.
Productividad es resultado, no movimiento
Personalizar un entorno puede ser aprendizaje valioso. Experimentar con agentes permite entender sus límites y descubrir ideas que después se convierten en herramientas útiles. Nada de eso necesita disfrazarse de productividad inmediata para tener valor.
La sobreingeniería comienza cuando dejamos de distinguir entre aprender, configurar y entregar. Si el objetivo es producir mejor software, la métrica debe incluir el resultado completo: tiempo, revisión, calidad, coste y mantenimiento.
El estudio de METR deja una lección más duradera que su 19%: nuestra sensación de velocidad puede apuntar en la dirección contraria a los datos. Por eso conviene empezar pequeño, comparar contra una línea base y conservar únicamente las capas que podamos justificar.
Si sospechas que tu equipo dedica más tiempo a la herramienta que al problema que debía resolver, puedo ayudarte a separar la infraestructura que aporta valor de la que solo añade movimiento. Escríbeme por WhatsApp o déjame un mensaje en mi página de contacto.
Fuentes y lecturas recomendadas
- Joel Becker, Nate Rush, Elizabeth Barnes y David Rein, Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity, METR, 2025.
- METR, materiales y datos del estudio, 2025.